Un 3 % más de memoria y hasta 30 veces más por dólar: NVIDIA explica cómo Vera Rubin NVL72 exprime cada byte para los agentes de IA
La compañía atribuye el salto a 288 GB de HBM4 mejor aprovechados, al formato NVFP4 de 4 bits, a la CPU Vera y al traslado del contexto inactivo fuera de la GPU.
Lip-Bu Tan, CEO de Intel (66 años): «La situación va a empeorar... Los precios de la memoria se han multiplicado por entre cinco y siete»
Es oficial: SpaceX se compromete a alquilar por unos 40.000 millones de dólares los chips de IA que comprará Apollo y los recibirá desde 2027
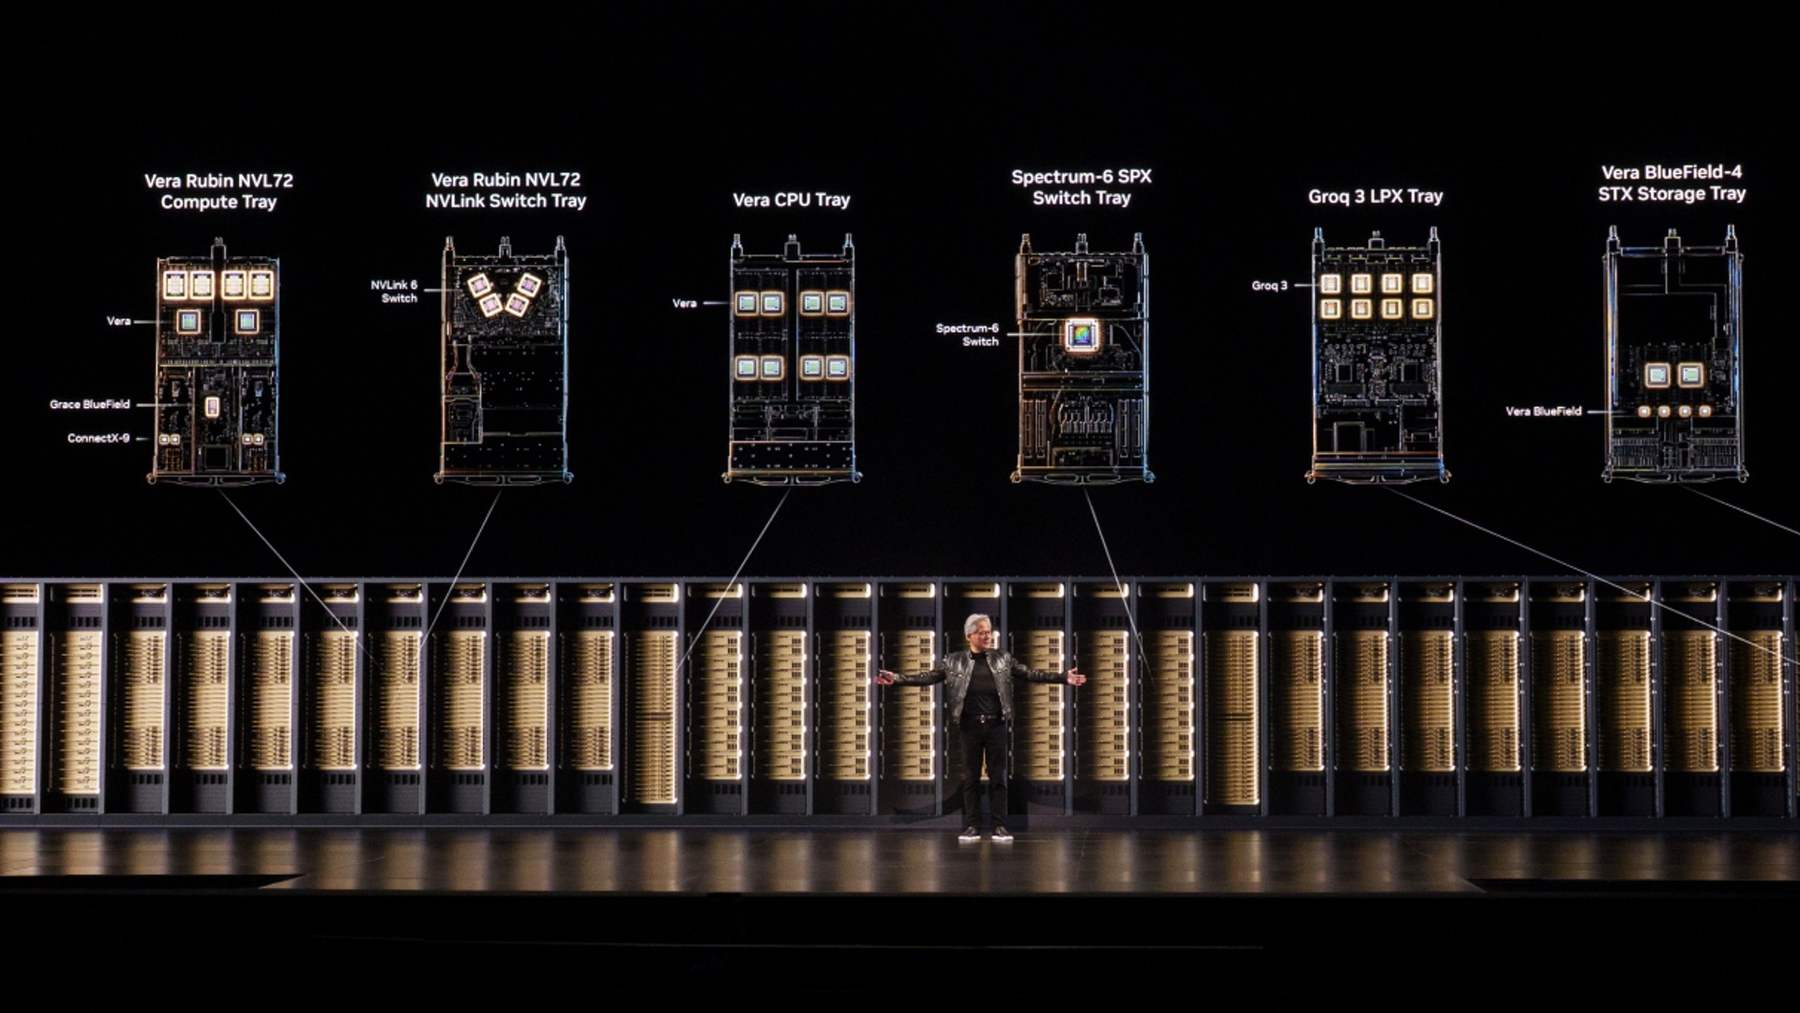
NVIDIA asegura que su sistema Vera Rubin NVL72 rinde hasta 30 veces más por dólar que el GB300 NVL72 con agentes de inteligencia artificial. Y lo hace con apenas un 3 % más de memoria HBM por GPU. La cifra aparece en una entrada de su blog oficial, firmada por Amr Elmeleegy el 5 de noviembre de 2026.
Elmeleegy escribe que «el suministro se reduce y los precios suben», y el texto prevé que la tendencia continúe a corto plazo. En septiembre, el consejero delegado de Intel ya habló de precios de la memoria multiplicados por entre cinco y siete. Cada gigabyte ahorrado vale hoy bastante dinero.
Hasta tres millones de tokens
La HBM es la memoria rápida que va montada junto a la GPU, el procesador que hace los cálculos de la IA. Es también la más cara de un centro de datos. Allí compiten dos ocupantes, los pesos del modelo y la llamada caché KV.
Los pesos son los valores aprendidos en el entrenamiento. La caché KV guarda el contexto de cada petición para no procesarlo otra vez.
Con los agentes de IA ese contexto no para de crecer, porque pasa de una llamada a la siguiente. NVIDIA habla de trayectorias que, en algunos casos, procesan hasta 3 millones de tokens, las unidades de texto de estos sistemas. De esa memoria depende cuántos usuarios se atienden a la vez, tanto en contratos de chips de 40.000 millones de dólares como en el centro de datos proyectado en Egipto.
288 GB y 19,2 TB/s
Eduardo Alvarez, Jamie Li y Ronil Prasad firman la nota técnica de NVIDIA. Su planteamiento cabe en una frase: «La pregunta ya no es cuánta memoria tiene una GPU, sino cuánto trabajo útil entrega cada byte».
Cada GPU Rubin lleva hasta 288 GB de HBM4. El rack completo suma unos 20,7 TB entre sus 72 procesadores gráficos.
Para explicar por qué ampliar la capacidad no basta, Elmeleegy recurre a la logística. «Imagina la HBM como un almacén y el ancho de banda de memoria como sus muelles de carga», escribe. Un almacén mayor guarda más mercancía, añade, pero los muelles fijan cuánta entra y sale.
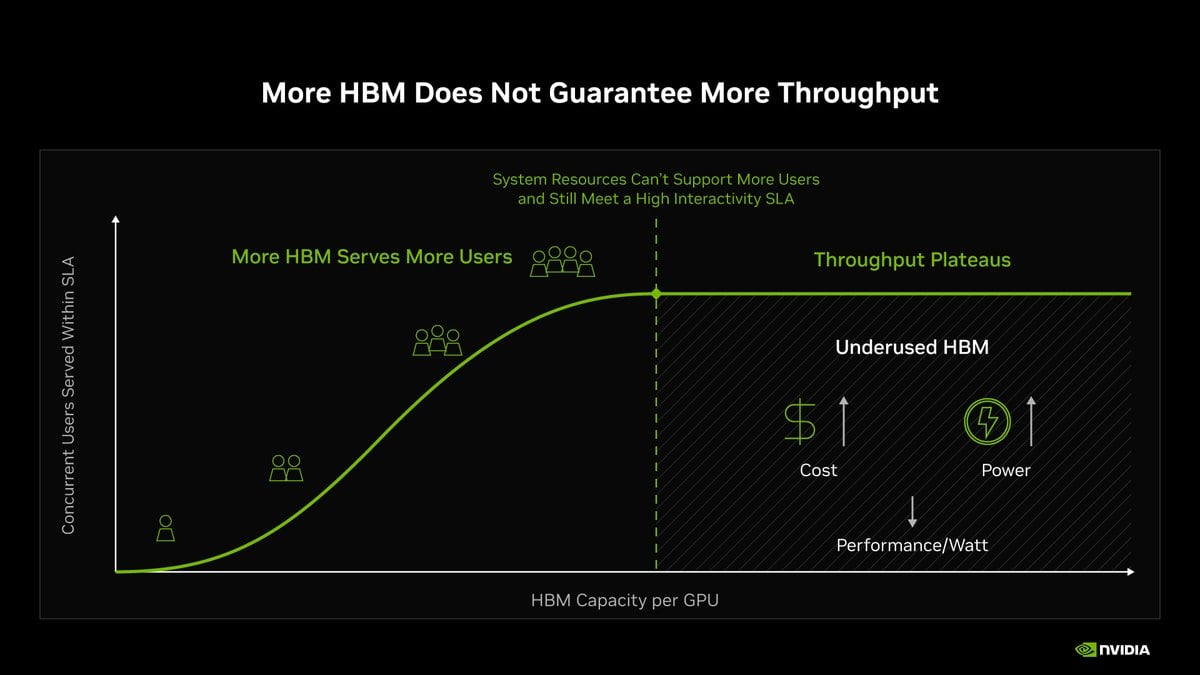 Gráfico de NVIDIA: los usuarios atendidos crecen con la HBM hasta que el rendimiento se estanca. (Imagen: NVIDIA)
Los ingenieros llaman muro de memoria al momento en que esos muelles se saturan. A partir de ahí, según NVIDIA, la HBM extra suma coste y consumo sin aportar rendimiento. Entre el GB300 y Rubin, el ancho de banda subió hasta 19,2 TB/s con la capacidad casi sin cambios.
Pesos de 4 bits
La primera medida consiste en encoger lo que se guarda. El formato NVFP4 usa 4 bits por valor. Según los autores, reduce el tamaño del modelo unas 3,5 veces frente a FP16 y 1,8 veces frente a FP8.
En la caché KV, el mismo formato recorta hasta un 50 % respecto a FP8.
Un NVL72 también puede repartir los pesos entre sus 72 GPU. Así cada una guarda una parte menor y le queda más HBM para el contexto. FLUX.2 [klein], de Black Forest Labs, y Muse Spark, de Meta, ya se han lanzado con este formato.
Contexto aparcado en Vera
Un agente alterna los pasos del modelo con trabajo en el procesador central, como ejecutar código o consultar una base de datos. Durante esas pausas, su caché KV ocupa HBM sin producir nada. «Una CPU lenta cuesta a la HBM dos veces: primero como ocupación ociosa y luego como recálculo», señalan los autores.
La CPU Vera aporta 88 núcleos y hasta 1,5 TB de memoria LPDDR5X. Son más de cinco veces la HBM4 de una GPU Rubin. Ambos chips se comunican a 1,8 TB/s, unas siete veces lo que permite un enlace PCIe Gen 6 x16.
El contexto que tarda más en volver baja otro escalón. El software Dynamo vigila dónde está cada bloque y lo traslada a CMX, un almacenamiento flash compartido entre servidores. Su coste por bit queda muy por debajo del de la HBM.
NVIDIA atribuye a CMX hasta 5 veces más tokens por segundo que el almacenamiento tradicional con contextos largos. La eficiencia energética mejora en la misma proporción, siempre según la empresa.
NVIDIA explica cinco formas de afrontar el muro de memoria de la IA. Vídeo: NVIDIA Developer
Una prueba con DeepSeek V4 Pro
El dato de las 30 veces procede de SemiAnalysis AgentX. Esta prueba reproduce sesiones grabadas de agentes de programación, con sus pausas para herramientas y su contexto creciente. NVIDIA la ejecutó con la carga de DeepSeek V4 Pro, a 125 tokens por segundo para cada usuario.
La generación anterior mejoró menos con bastante más memoria. El GB300 NVL72 rendía hasta 10 veces más por dólar que la plataforma H200, a 100 tokens por segundo y usuario. Para eso duplicó aproximadamente la HBM por GPU.
«La capacidad por sí sola no puede explicar una ganancia de 30 veces», escriben los autores de la nota técnica.
Dólares, megavatios y 288 GB
Las dos entradas de NVIDIA no miden exactamente lo mismo. El blog general habla de 30 veces más por dólar a 125 tokens por segundo y usuario. La nota técnica da 30 veces más por megavatio a 160 tokens.
Esa nota presenta además los 288 GB como capacidad igual en ambas generaciones, frente al 3 % del blog. Todas son cifras máximas, comunicadas por el fabricante para una carga concreta. Las entradas no incluyen el precio de los sistemas ni el detalle del cálculo por dólar.
Tampoco reparten el salto entre cada mejora. En un centro de datos real, el resultado dependerá del modelo, de los usuarios y de la velocidad exigida.
La explicación completa se ha publicado en el blog técnico de NVIDIA.
Crédito de la imagen: NVIDIA.
Temas:
- Nvidia
- Tecnología
Lo último en Techy
-

Un 3 % más de memoria y hasta 30 veces más por dólar: NVIDIA explica cómo Vera Rubin NVL72 exprime cada byte para los agentes de IA
-
26 toneladas de carga, 870 km/h y repostaje en vuelo: Grecia compra hasta 6 aviones KC-390 Millennium a Embraer y será el séptimo país europeo en elegirlo
-
Meta extiende con IA a todo el mundo la búsqueda de menores que mienten con su edad en Instagram: dice que millones pasarán a Cuentas para Adolescentes
-
Un billón de parámetros y gratis para descargar: Mistral Large 4, la IA europea que rechaza el 96,6 % de las peticiones de ciberataque y aun así preocupa
-
Northrop Grumman confirma que el bombardero B-21 Raider ya ha demostrado que puede lanzar armas y entra en pruebas de armamento antes de llegar a Ellsworth en 2027
Últimas noticias
-
El debate de las elecciones del 29-N será el 26 de noviembre: los candidatos se verán las caras antes de las urnas
-
Un 3 % más de memoria y hasta 30 veces más por dólar: NVIDIA explica cómo Vera Rubin NVL72 exprime cada byte para los agentes de IA
-
Baena lo deja claro con Lamine Yamal: «Si alguna vez hay un trato de favor, lo entenderíamos todos»
-
Álvarez de Toledo responsabiliza a Sánchez de las agresiones en campaña: “Ha legitimado la violencia política en España”
-
Los chefs españoles coinciden: «Después de aliñar los tomates con sal y aceite de oliva, es recomendable esperar entre 5 y 10 minutos antes de servirlos»