Cuatro de las IA más potentes pierden el hilo en documentos largos: StateBench, del Allen Institute, las hunde al 13 % de precisión o menos
Los cuatro modelos rindieron bien en los dos niveles fáciles, pero su acierto se desplomó entre 10.000 y 64.000 tokens en los dos más difíciles.
OpenAI rebaja a la mitad el precio de su IA que maneja el ordenador: GPT-6.1 Terra cuesta 1 dólar por millón de tokens y triplica la velocidad
Ni GPT-6 ni Claude Opus 5.5: Gemini 4 Carbon, de Google, lidera con 59 puntos y detecta el 88,2 % de los fallos de SEC-bench Pro

El Allen Institute for AI (Ai2) publicó el 3 de noviembre StateBench, una prueba sobre datos que cambian dentro de un documento largo. Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol y GPT-6 Luna cayeron al 13 % de precisión o menos. Ocurrió en los problemas más largos del nivel más difícil.
Jackson Petty, William Merrill y Ashish Sabharwal firman el informe técnico. Los tres trabajan en el Ai2, y los dos primeros figuran también en la Universidad de Nueva York y en el Toyota Technological Institute at Chicago. Según su resumen, ningún modelo preentrenado «resuelve de forma robusta ni siquiera» el tercero de los cuatro niveles.
Del cumpleaños a los cubiletes
El seguimiento de estado consiste en saber cuánto vale algo tras una cadena de cambios. Puede ser una variable en un programa o un cuchillo que pasa de mano en mano en una novela policiaca. El Ai2 lo dividió en cuatro niveles comparables, con el mismo número de variables y de valores.
En el primero, llamado r-trivial, el dato nunca cambia, igual que una fecha de nacimiento. Después llega el aperiódico, donde basta con encontrar el último valor. Un termostato funciona así, porque manda su ajuste más reciente.
Los dos últimos obligan a arrastrar toda la historia. En el soluble cada cambio se suma al anterior, como en el marcador de un partido. En el general finito, una variable puede tomar el valor actual de otra.
Para explicarlo, el instituto recurre a un mago que esconde una bola bajo uno de cinco vasos y los intercambia una y otra vez. Basta perder un solo cambio para señalar el vaso equivocado.
Hundimiento hasta el 0 %
Los investigadores pidieron a los cuatro modelos el valor final de todas las variables de cada secuencia. Todos rindieron bien en los dos niveles fáciles. GPT-6 Luna fue el que más bajó, hasta el 87 % en el tramo más largo del aperiódico.
La caída llegó con los problemas soluble y general finito. En el gráfico del instituto, Gemini 3.8 Flash termina en el 3 % y el 13 %, respectivamente. Claude Opus 5.5 acaba en el 53 % y el 3 %.
GPT-6 Sol se queda en el 3 % y el 0 %, y GPT-6 Luna marca 0 % en ambos casos. El informe sitúa el desplome entre 10.000 y 64.000 tokens, la unidad en la que estos modelos trocean el texto, y lo describe como acierto de azar en los dos niveles difíciles. Claude Opus 5.5 es la excepción en el soluble, donde su curva cae y luego remonta hasta el 53 %.
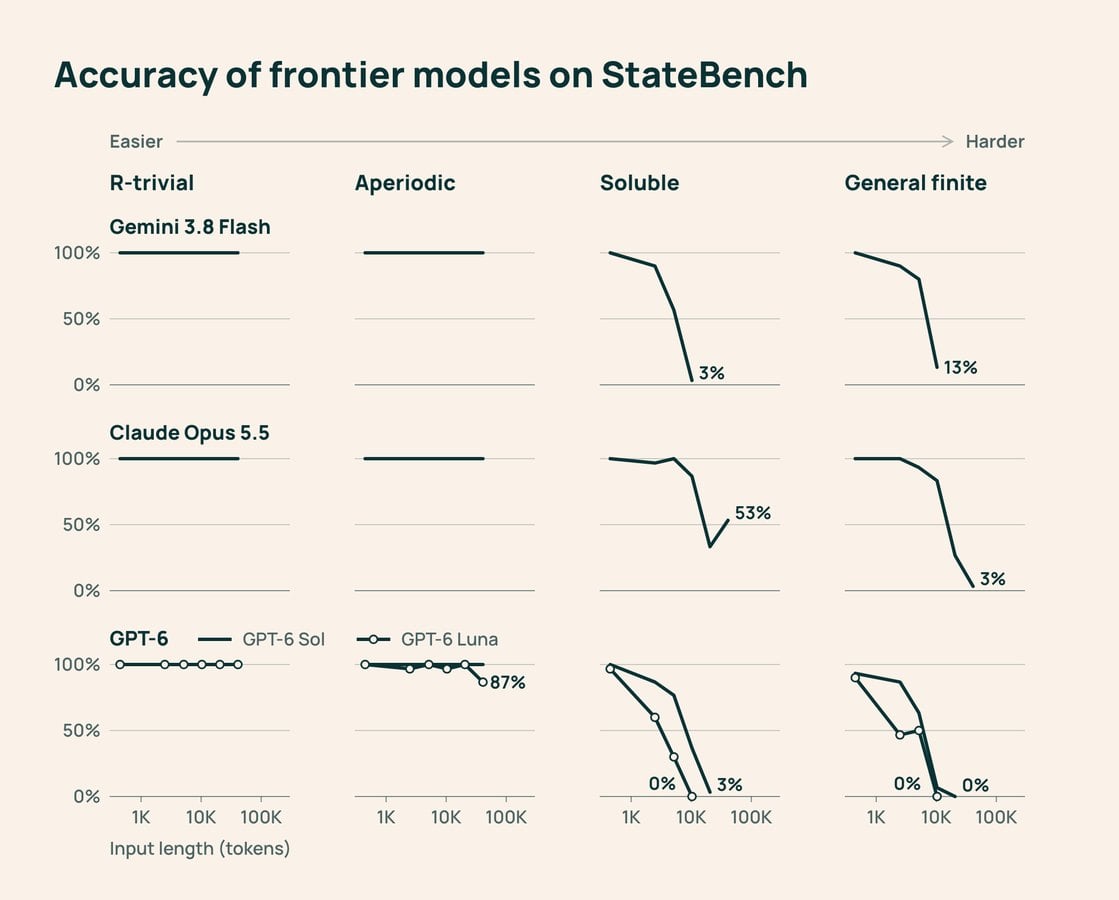

El Ai2 apunta a la sensibilidad de estas tareas como factor probable. En los niveles difíciles, muchos más pasos pueden alterar la respuesta final. Según el instituto, «queda menos margen para que un modelo pase por alto una actualización» sin equivocarse.
Memoria continua frente a transformers
La segunda parte del trabajo buscaba separar los límites de la arquitectura y los del entrenamiento. El equipo entrenó desde cero seis modelos de 275 millones de parámetros. Había dos transformers, basados en mecanismos de atención, dos híbridos y dos Gated DeltaNet, redes recurrentes que arrastran una memoria mientras leen.
Esos modelos practicaron con secuencias de hasta 256 asignaciones. Luego se examinaron con hasta 64.000, unas 250 veces más. Gated DeltaNet y los híbridos rozaron la perfección en los tres primeros niveles, y los transformers nunca aprendieron el general finito.
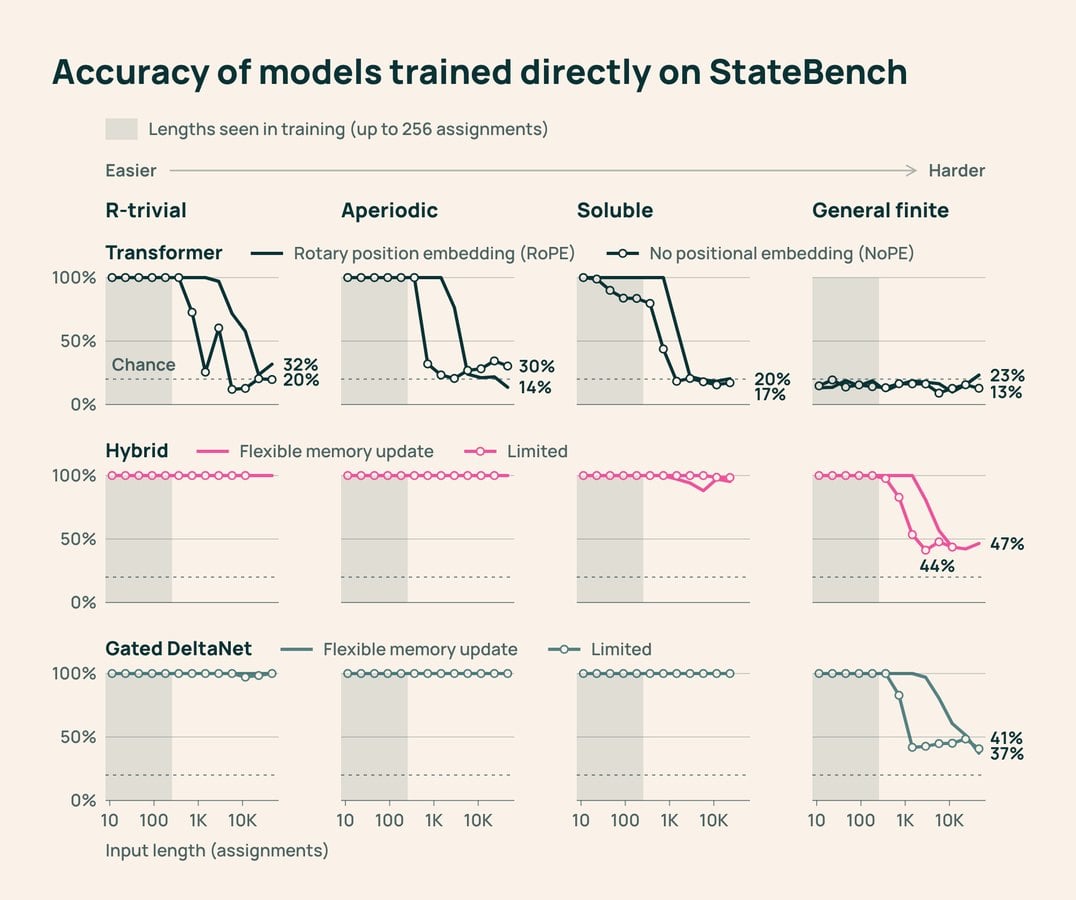

En ese último nivel destacó la variante de Gated DeltaNet con memoria más flexible. Se mantuvo casi perfecta hasta unas 10 veces la longitud de sus ejemplos. Para recurrentes e híbridos, escribe el Ai2, la diferencia «apunta al entrenamiento más que a la arquitectura».
Mismo problema, formato de hoja
Los modelos abiertos preentrenados incluían Olmo 3 y Olmo Hybrid, de 7.000 millones de parámetros. Casi todos acertaron en el nivel r-trivial y perdieron precisión en el aperiódico al crecer la entrada. En el general finito se quedaron en el azar.
El formato también pesó en el resultado. Los híbridos y Gated DeltaNet más pequeños rozaron el máximo con problemas r-trivial al estilo de la prueba RULER. Cayeron cerca del azar cuando la misma tarea aparecía como ediciones de una hoja de cálculo.
Según los autores, entender muchas tareas con código real exige más seguimiento del que logran hoy estos modelos. Sus datos y su código están publicados para que otros equipos repitan las pruebas.
Variables fijas y secuencias sintéticas
StateBench asume un número fijo de variables. El propio Ai2 admite que su marco aún no cubre conversaciones largas donde aparecen personas y objetos nuevos. Al tratarse de secuencias sintéticas, el 13 % tampoco indica cuántas veces falla un chatbot al resumir un contrato.
Las cifras por modelo no sirven como clasificación, porque las curvas del gráfico no terminan en la misma longitud. La de Gemini acaba antes que la de Claude. Además, los modelos cerrados escribían la respuesta y los abiertos elegían entre cinco opciones.
La lista deja fuera a otros sistemas como GPT-6.1 Terra, el modelo de OpenAI que maneja el ordenador, o Gemini 4 Carbon, de Google. Tampoco midió agentes en uso real, como la extensión de ChatGPT que controla las pestañas de Chrome.
El informe técnico se ha publicado en arXiv.
Crédito de la imagen: Allen Institute for AI (Ai2).
Lo último en Techy
-
Cuatro de las IA más potentes pierden el hilo en documentos largos: StateBench, del Allen Institute, las hunde al 13 % de precisión o menos
-
Un modelo interno de OpenAI comprobó 362 direcciones de monedero, gastó fondos de prueba ajenos y no lo contó en su respuesta final: la empresa lo ha revelado
-
Adiós a los F-15C de Okinawa: el primer caza F-15EX Eagle II ya está en Kadena, la primera base aérea de EEUU en el extranjero que lo recibe
-
Siete piezas reemplazables, 40 horas de música y 119 euros: así son los auriculares Fairbuds 2 que sobreviven a una batería gastada
-
Nació hace 13.000 millones de años y orbita al revés que la Vía Láctea: así es M30, el cúmulo globular que el Hubble retrata con datos de tres programas
Últimas noticias
-
Estos son los alimentos que aceleran el metabolismo y ayudan a quemar más calorías en los hombres
-
Cuatro de las IA más potentes pierden el hilo en documentos largos: StateBench, del Allen Institute, las hunde al 13 % de precisión o menos
-
La psicología lo confirma: las personas desordenadas pueden ser más creativas y tener una inteligencia diferente a la que imaginamos
-
Feijóo se compromete a reformar la financiación y aprobar el ‘plan Valencia’ en un vídeo dirigido a los valencianos
-
Los expertos en peluquería coinciden en la técnica para conseguir una melena con más volumen: «Necesitamos secar el pelo en sentido contrario de cómo crece naturalmente»