Ni la nube ni un superordenador: NVIDIA PAIR reparte gratis la IA entre los PC de casa y, en su demo, baja una tarea de 18 minutos a menos de 10
El programa de NVIDIA envía cada petición de un agente de IA al ordenador libre de la red doméstica y funciona con Ollama, LM Studio y llama.cpp en Windows, Linux y macOS.
Nvidia reta a Intel y AMD con el lanzamiento del primer PC impulsado por IA
Microsoft y NVIDIA quieren que la IA viva en tu portátil y no en la nube, y hoy enseñan cómo
NVIDIA publicó el 13 de octubre de 2026 la primera versión estable de NVIDIA PAIR, un programa gratuito y de código abierto que reparte las tareas de inteligencia artificial entre los ordenadores conectados a una misma red doméstica. En la demostración de la propia empresa, tres equipos terminaron en 8 minutos y 48 segundos un trabajo que a un solo portátil le llevaba 18 minutos.
La herramienta se presentó en beta el 3 de septiembre en la feria IFA de Berlín y salió de esa fase tres días antes del lanzamiento de los primeros ordenadores con el procesador RTX Spark, fijado para el 16 de octubre, según el blog oficial de NVIDIA. Funciona en Windows, Linux y macOS.
Un enrutador para la IA
PAIR son las siglas de Personal AI Router, enrutador personal de IA. La idea parte de un dato que NVIDIA da en la nota de la IFA: más de la mitad de los hogares de Estados Unidos tienen dos o más ordenadores, y buena parte de esa potencia se queda parada durante el día.
Según el blog técnico de la empresa, el programa no ejecuta modelos por su cuenta: PAIR localiza los equipos de la red y envía cada petición independiente a uno que esté libre y tenga el modelo pedido, donde la resuelve Ollama, LM Studio o, desde la versión 1.0, llama.cpp, los programas que ejecutan modelos de lenguaje en un PC.
Para la aplicación que hace la consulta no cambia nada, porque PAIR ocupa el puerto de Ollama o LM Studio y responde por ellos. El blog lo resume así: el agente decide qué trabajo pide y PAIR decide dónde se ejecuta.
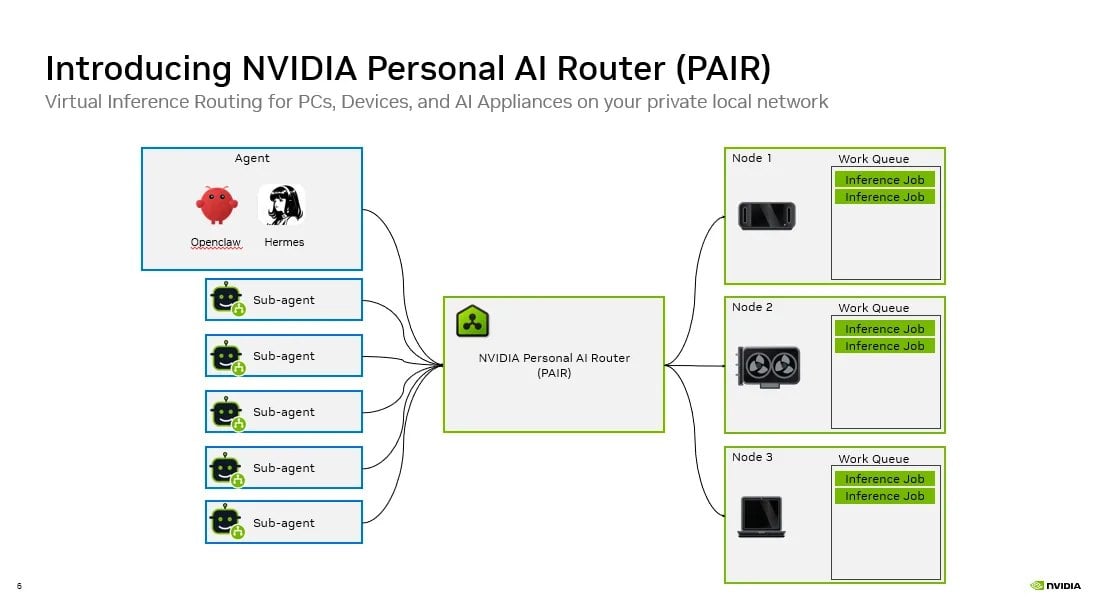 Esquema de NVIDIA: los subagentes de OpenClaw o Hermes envían sus peticiones a PAIR, que las reparte entre tres equipos de la red. (Foto: NVIDIA)
NVIDIA lo plantea también como una forma de dejar libre el ordenador principal para jugar o editar vídeo mientras otros equipos atienden al agente, en la línea de la IA en el propio equipo que la empresa y Microsoft defienden con los portátiles con RTX Spark.
El plan del domingo de Hermes
Para enseñarlo, NVIDIA usó Hermes, un agente de Nous Research que divide los encargos entre subagentes, agentes auxiliares que se ocupan cada uno de una parte. La tarea consistía en revisar una bandeja de correo ficticia y preparar un plan con lo que había que hacer esa noche, esa semana, más adelante o nunca.
Con el modelo Qwen 3.6 35B A3B en un solo portátil con RTX Spark, los cinco subagentes tardaron de media 18 minutos. Un grupo formado por ese portátil, un DGX Spark y un PC con una RTX 5090 lo resolvió en 8 minutos y 48 segundos, según el texto del blog técnico.
Demostración de NVIDIA PAIR repartiendo entre varios equipos el trabajo de cinco subagentes de Hermes. Vídeo: NVIDIA Developer
En el mismo texto, NVIDIA advierte de que se trata de «una demostración no oficial y específica de esta configuración, no una prueba general ni una promesa de escalado lineal».
Equipos que entran y salen
El blog técnico insiste en que una casa funciona de otra manera que un centro de datos. Un PC de juegos se pone a ejecutar un juego, un portátil se cierra o se va a otra habitación, y en una estación de trabajo hay un modelo que en el portátil no está, así que PAIR revisa a cada momento quién puede aceptar trabajo nuevo.
Para unir dos ordenadores, uno muestra un PIN de seis dígitos y el otro lo teclea, explica la documentación del repositorio en GitHub. A partir de ahí el tráfico entre ellos viaja cifrado, y si el modelo, el motor y la aplicación están en casa, las peticiones y las respuestas están pensadas para no salir de la red.
GeForce, Mac y DGX Spark
No hace falta una tarjeta de este año: la guía técnica de NVIDIA admite desde las GeForce RTX 20 hasta el DGX Spark, y también los Mac con M4 o posterior. Con la 1.0 llegaron llama.cpp y las descargas de modelos desde Hugging Face, y NVIDIA cuenta que, «solo un mes después del lanzamiento inicial de PAIR, la comunidad ya ha aportado más de 10 funciones y correcciones».
Una petición, una sola tarjeta
PAIR no suma la memoria de varias tarjetas gráficas ni reparte un mismo modelo o una misma petición entre varias máquinas, aclara el repositorio. Un modelo que no cabe en ninguna de las tarjetas de la casa seguirá sin poder ejecutarse.
Para usar modelos que caben en un PC doméstico, como el Muse Glimmer de Meta, cada equipo que vaya a recibir trabajo debe tener ese mismo modelo descargado.
Una sola medida, y es de NVIDIA
La única medida publicada es la de NVIDIA, y no cuadra del todo: el texto habla de 8 minutos y 48 segundos y el gráfico que lo acompaña marca 9,8 minutos como media de cinco ejecuciones. Tampoco hay todavía pruebas independientes con otros agentes ni con más equipos.
La nota de la IFA y la guía técnica se publicaron el 3 de septiembre de 2026 en el blog de NVIDIA, y la versión 1.0 se anunció el 13 de octubre.
Crédito de la imagen: NVIDIA.
Lo último en Techy
-

Ni la nube ni un superordenador: NVIDIA PAIR reparte gratis la IA entre los PC de casa y, en su demo, baja una tarea de 18 minutos a menos de 10
-
Ni las bombas ni el acuerdo con EEUU lo han frenado: Irán acelera en 2026 las obras de la montaña Pickaxe, a 2 kilómetros de Natanz
-
Una empresa india asegura que su reactor ha dejado señales de 32 elementos, entre ellos itrio y uranio: así busca tierras raras con fusión nuclear, aún sin revisión por pares
-
1.169 CV y 450 km recargados en 10 minutos: el Mercedes-AMG GT SUV es el primer gran SUV que AMG crea desde cero en sus 59 años
-
La Kawasaki Ninja H2R sigue a la venta en 2027 con 326 CV: su compresor gira 9,2 veces más rápido que el cigüeñal y solo está pensada para circuito
Últimas noticias
-
La Ley de Bienestar Animal lo confirma y conlleva multa: se prohíbe a los dueños de perros y gatos usar cualquier utensilio que limite su movilidad
-
La profunda reflexión de Stephen Hawking, físico: «El mayor enemigo del conocimiento no es la ignorancia, es la ilusión del conocimiento»
-
La psicología confirma que los adultos que recogen la basura del suelo no son limpios, en realidad tienen «interiorizada la idea de que algunas cosas no son sólo responsabilidad de quien las ha hecho»
-
El tradicional ‘civet’ del empresario Luis Conde reúne a presidentes autonómicos, miembros del Gobierno y destacados empresarios en Gerona
-
Así queda la parrilla de salida para el GP de Estados Unidos de F1 2026 tras la clasificación en Austin