Arena, agua y proteínas con una sola arquitectura: la IA del MIT que simula seis fenómenos físicos y, según sus autores, modela proteínas unas 100 veces más rápido
El sistema predice paso a paso el movimiento de partículas, avanza 50 femtosegundos en proteínas frente a los 0,5 tradicionales y admite unas 50.000 partículas por tarjeta gráfica.
La inteligencia artificial que está diseñando proteínas nunca vistas
Así es el robot con músculo vivo del MIT: mide lo que un chicle, obedece a la luz y ya ha salido nadando de un laberinto

Investigadores del MIT y de la Universidad de Columbia Británica (UBC) han presentado WorldParticle, un sistema que simula seis fenómenos físicos con una misma arquitectura de IA. El MIT anunció el trabajo el 9 de noviembre de 2026. Minghao Guo, uno de sus autores, afirma que modela los cambios de las proteínas unas 100 veces más rápido que los simuladores numéricos.
Para reproducir hoy un proceso físico en un ordenador se suele elegir una herramienta por tarea. Hay programas para el agua que fluye y otros para el plegamiento de una proteína, escritos a mano alrededor de sus ecuaciones.
WorldParticle abarca telas, sólidos elásticos, dos tipos de fluidos, materiales granulares como la arena y la dinámica de las proteínas. Guo es investigador posdoctoral del MIT. Su colega Peter Yichen Chen pasó por esa institución y hoy es profesor ayudante en la UBC.
Partículas que avanzan como palabras
Cada objeto se descompone en una nube de puntos tridimensionales, y el sistema sigue el recorrido de cada uno. Esa técnica se conoce como representación lagrangiana. Una red neuronal recibe la posición y las propiedades de los puntos y calcula cómo estarán en el fotograma siguiente.
«Es una arquitectura parecida a la de ChatGPT. Pero en lugar de predecir una palabra cada vez para escribir un texto, predecimos cómo se moverán estas partículas, paso a paso», explica Chen en la nota del MIT.
Según esa nota, la red aprende a resolver de forma general las ecuaciones del movimiento. El equipo no tiene que diseñar así un programa nuevo para cada material. Las fuerzas externas, como una ola que golpea un dique, se tratan aparte y luego corrigen la predicción.
Como un objeto complejo suma muchísimos puntos, los autores los fusionan y comprimen por etapas. El artículo técnico llama «supertokens» a esos grupos. Gracias a ellos, zonas alejadas del objeto se comunican sin comparar cada partícula con todas las demás.
Tigres de arena sin granos flotantes
En fluidos, telas y arena, el equipo enfrentó WorldParticle a tres simuladores neuronales anteriores. Los autores describen en esos rivales granos de arena flotando en el aire y telas con un comportamiento explosivo. También vieron materiales que se atravesaban en las simulaciones largas.
Su modelo mantuvo simulaciones estables y próximas a la referencia, generada con solucionadores físicos consolidados. Los escenarios de prueba cambiaban viscosidades, obstáculos, fricciones o formas iniciales respecto al entrenamiento.
Unir mundos que hoy se calculan por separado es la ambición del proyecto. «Si estudias objetos deformables y fluidos, necesitarías dos simuladores, uno para cada régimen físico», señala Guo. El MIT pone como ejemplo el aceite que se agita en un tanque y golpea una válvula elástica.
Pasos de 50 femtosegundos en proteínas
El artículo técnico da una pista sobre las 100 veces que cita Guo. Las simulaciones tradicionales avanzan en pasos de 0,5 femtosegundos, y WorldParticle lo hace en pasos de 50, cien veces mayores. Lo que documenta el artículo es el tamaño del paso, no una medición del tiempo total de cálculo. Un femtosegundo es la milbillonésima parte de un segundo.
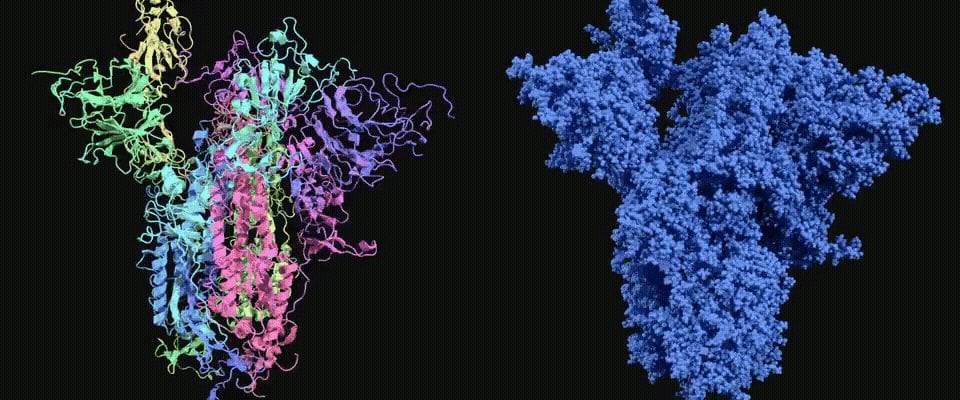

Con esos saltos, una tarjeta gráfica Nvidia A100 de 80 GB generó 14,7 fotogramas por segundo con proteínas. En telas llegó a 24 y en arena, a 11,5. Las dos proteínas analizadas tenían unos 2.000 y 6.000 átomos, en un terreno donde la IA ya diseña moléculas nuevas.
Un pato inflable en la rampa
Tres aplicaciones acompañan al estudio. En la primera, una interfaz en tiempo real permite aplicar fuerzas de cualquier dirección y magnitud sobre un objeto deformable.
La segunda parte de un pato hinchable que baja por una rampa y se desliza por el suelo. Con el modelo ya entrenado, los investigadores buscaron la fricción exacta para detenerlo en un punto marcado. El valor obtenido dejó al pato en ese destino.
En la tercera, el sistema aprendió de nubes de puntos del mundo real, sin un simulador clásico de por medio. Fueron tres secuencias de manipulación de objetos. El equipo ha publicado el código de inferencia en GitHub y lo explica en su página oficial.
Entre los próximos objetivos, el MIT menciona la manipulación con robots blandos, la evolución del ARN y la fusión de galaxias. También quiere construir un sistema completo de simulación para el descubrimiento científico, una línea cercana a otros trabajos del instituto como la memoria en tiempo real para robots.
Cincuenta mil partículas como techo
El propio artículo matiza la idea de un simulador universal. Los autores entrenan un modelo con parámetros propios para cada categoría física. Comparten arquitectura, pero todavía no existe una única red que lo resuelva todo.
La principal limitación es la memoria, porque una tarjeta A100 admite unas 50.000 partículas. La nota del MIT habla de objetos con millones de puntos, una escala aún pendiente de variantes más eficientes.
Las pruebas con proteínas cubren solo 5 picosegundos, calculados en el vacío. El propio equipo sitúa el plegamiento y otros procesos biológicos entre los microsegundos y los milisegundos. El mayor error de posición de la tabla corresponde a los fluidos, la categoría con las secuencias más largas.
«Queremos tener un momento GPT para la simulación», resume Chen, que describe el resultado como «un primer paso en esa dirección». Ningún descubrimiento físico nuevo ha salido todavía de este sistema.
El estudio se presentará en la conferencia SIGGRAPH Asia y su versión completa está en arXiv.
Crédito de la imagen: Cortesía de los investigadores / MIT News.
Lo último en Techy
-
Arena, agua y proteínas con una sola arquitectura: la IA del MIT que simula seis fenómenos físicos y, según sus autores, modela proteínas unas 100 veces más rápido
-
20 reactores probados en el desierto de Nevada y 1.400 millones de dólares: así fue el cohete nuclear NERVA, que EEUU canceló en 1973 sin llegar a volar
-
Un 58 % menos de tiempo y más del 70 % de los informes sin retocar: así es PlanAssist, la IA de Google DeepMind que llega a 15 ayuntamientos ingleses
-
Nathan Moore, físico de Sandia, sobre cómo desviar un asteroide con una explosión nuclear: «Elige el lado correcto y ganas. Si te equivocas, podría ser un mal día»
-
Cabe un Boeing 737 y seis ventiladores de 12,2 metros empujan el aire: así es el túnel de viento más grande del mundo, que la NASA tiene en California
Últimas noticias
-
Telefónica: la ciudad flotante
-
Predicción del horóscopo para Escorpio hoy, jueves 12 de noviembre de 2026
-
La emotiva reflexión de Sara Carbonero (42 años): «Tengo miedo a la muerte. Cuando alguna vez me viene el pensamiento intrusivo, más que por mí, es por la gente que se queda»
-
La lección de vida que deja Tom Hanks sobre la felicidad: «El invierno debe ser muy frío para aquellos que no tienen cálidos recuerdos»
-
Fernando Fernán Gómez, novelista, sobre la Guerra Civil: «Lo que más recuerdo es la tremenda diferencia entre el sentir de los protagonistas y el de la gente común»